金鱼:把 AI 短片做成「流水线」——从剧本到成片的 15 节点生产流程
用 AI 做一个短片不难,难的是做出一条能交付的片子:人物第 3 个镜头就换了脸、同一件衣服颜色前后不一致、背景突然从宫殿变成了灰棚、字幕被烧进画面、音乐忽大忽小……这些问题的根源不是模型不行,而是流程没有工程化。这套「金鱼」流程要解决的就是这件事——把一部短片拆成 15 个可检查、可回退、可并行生产的节点。
这套流程能做什么
- AI 剧情短片 / 漫剧:从一句需求到成片(分镜、角色、场景、台词、配乐、字幕全链);
- 角色一致性控制:三视图 + 定妆照 + 脸部裁切的多参考体系,跨镜头、跨段落锁住同一个人的脸;
- 专业级后期:整片高清修复(FlashVSR)、原生对白修复、字幕识别校对、交付校验;
- 真实照片入片:把真人照片变成同款 AI 角色,或让照片以「镜中世界」的方式出现在剧情里;
- 成本可控:生图按张计价(几分钱到几毛钱),视频按段生成(10 秒约 ¥0.06 级),全流程费用透明可预算。
全流程总览:15 个节点
整条流水线分三段:前期(1–9 节点,建立世界观与资产)→ 生成(10–11 节点,产出画面与视频)→ 后期(12–15 节点,剪辑成片)。每一步都有明确的输入、输出和验收标准,不会「做一步看一步」。
| # | 节点 | 产出物 | 关键点 |
|---|---|---|---|
| 1 | 剧本 | 场次/地点/时间/人物 + 对白 | 结构化格式,动作与台词分离 |
| 2 | 导演分镜脚本 | 16 镜 7 字段表(镜号/景别/运镜/情绪/台词/音效/时长) | 每 8 镜一张手绘 contact sheet |
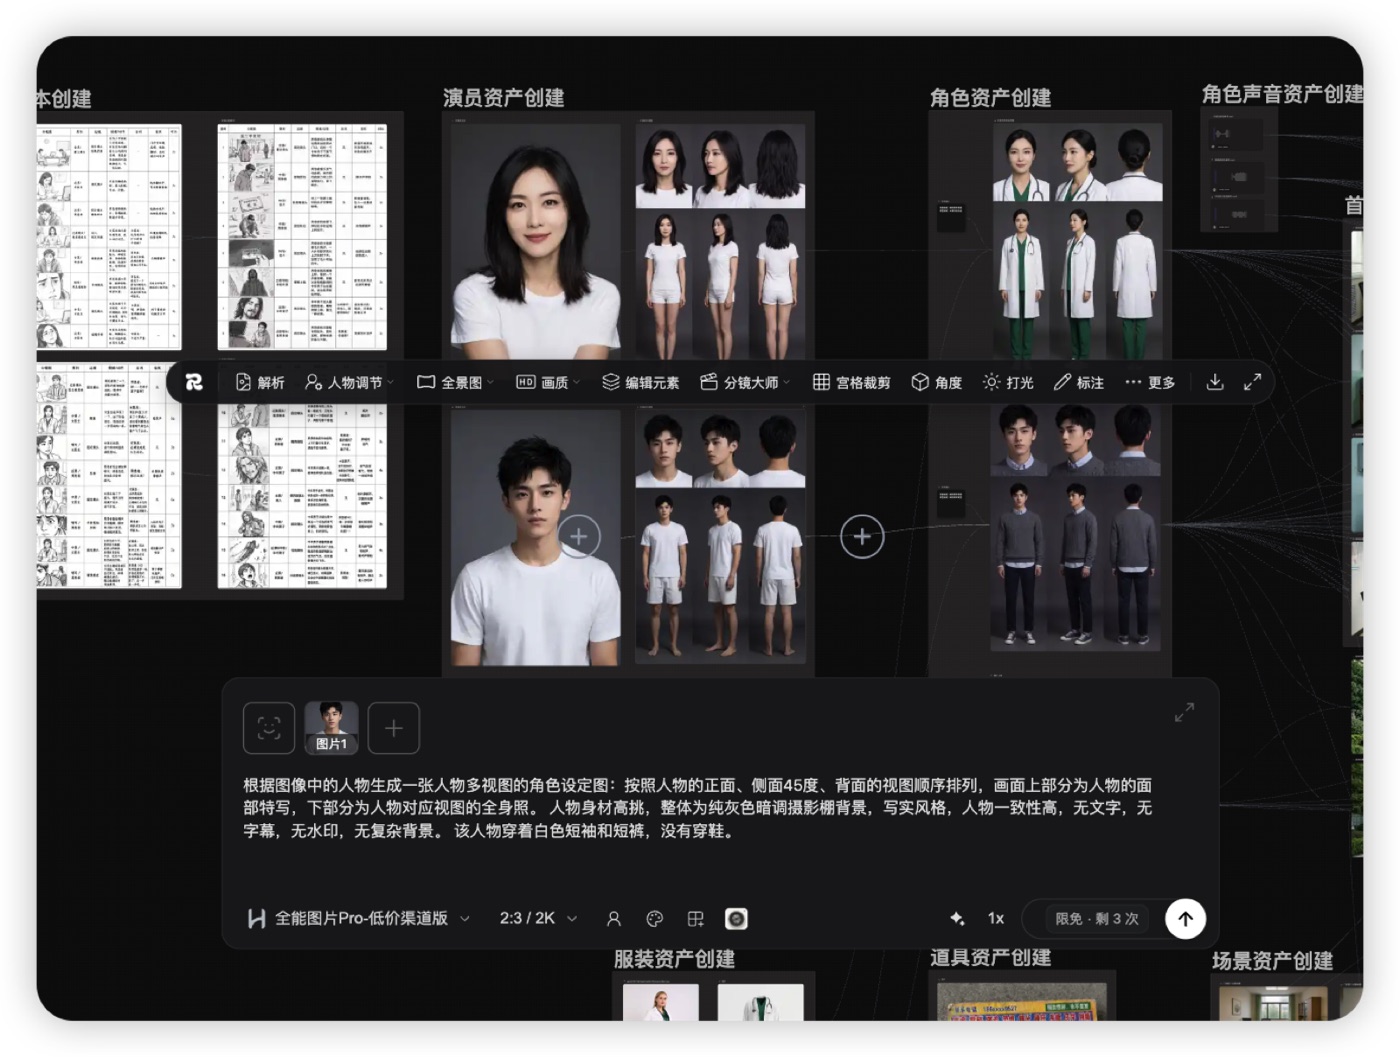
| 3 | 演员生成 | 角色参考图 | 授权脸部裁切 → 明确「严格锁定面部特征」 |
| 4 | 三视图 | 正面/侧面/背面全身 + 面部特写 | 纯灰摄影棚底、白 T 短裤,不带风格滤镜 |
| 5 | 化妆与发型 | 定妆图 | 妆容/发型/服饰三段式描述 |
| 6 | 角色声音 | 音色参考 | mp3 参考 + 音色描述 |
| 7–9 | 服装 / 道具 / 场景资产 | 资产参考图 | 无人物、无文字、无水印 |
| 10 | 首帧锚点 | 每段第一帧定稿 | 锚点 = 全片一致性的唯一基准 |
| 11 | 四宫格 + 视频 | 分镜四宫格 + 按段视频 | 整段一次生成,段间用过渡衔接 |
| 12 | 剪辑 + 修音 | 无字幕母版时间轴 | 原生对白驱动,局部问题局部修 |
| 13 | 整片高清 | 高清无字幕母版 | FlashVSR 按帧覆盖、按序拼接 |
| 14 | 字幕 | 字幕成片 + SRT | 从最终音轨识别,逐句人工校对 |
| 15 | 交付 | 完整交付包 | 路径/时长/尺寸/大小/校验值齐全 |
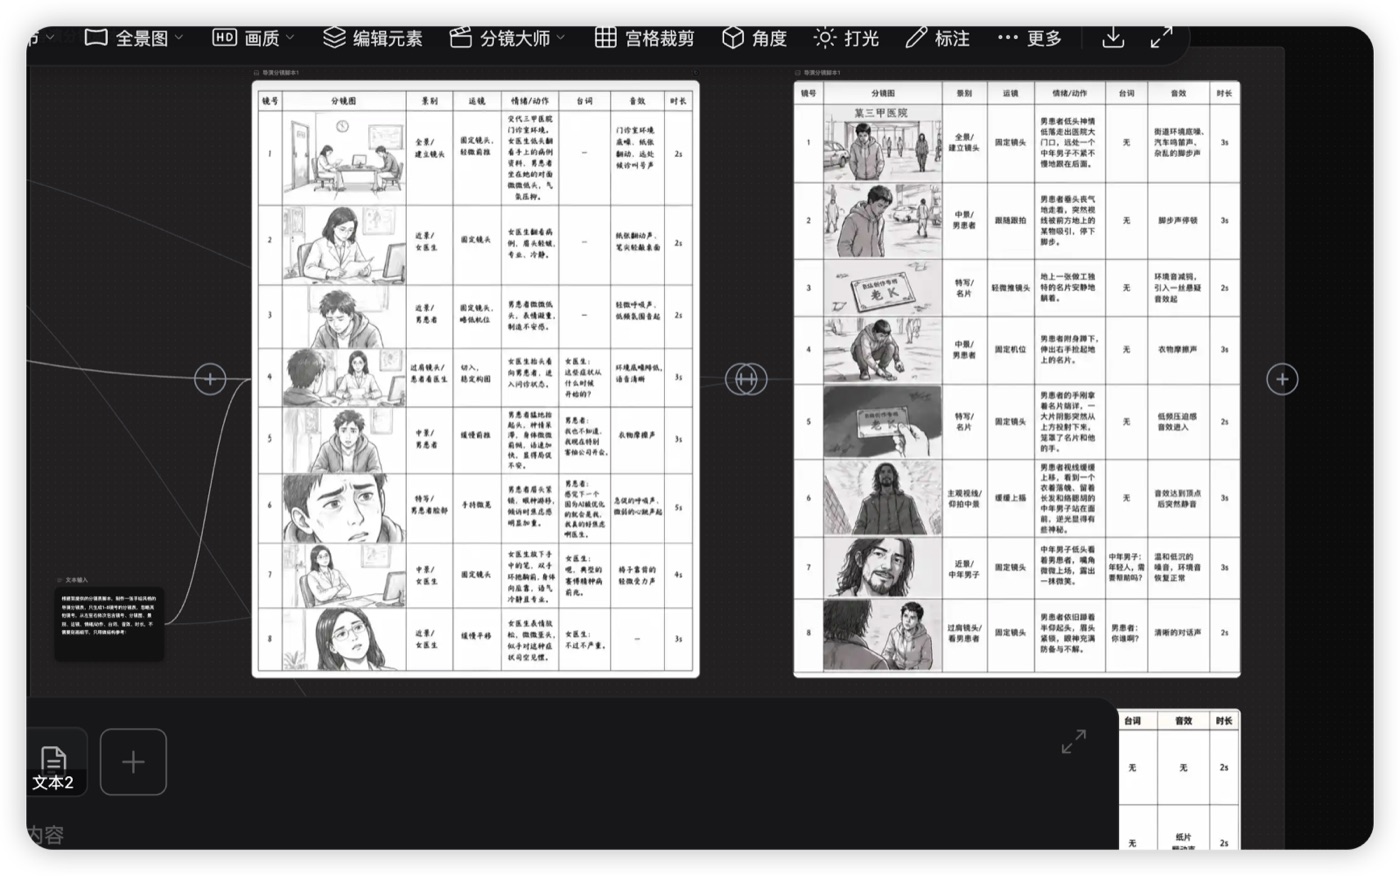
这套流程从哪里来:源起与蒸馏
先说清楚出处:这套生产流程不是凭空发明的,它蒸馏自 B 站 UP 主 YZ_金鱼(57000+ 粉的 AI 影视技术分享作者)的实战教学和其在 RunningHub 上的官方画布范例。原始素材是「一小时的长视频 + 一张画布」,信息密度极高,但视频里的执行细节散落在几十分钟的口播里,画布也只能「看」不能直接跑。
我做的工作就是蒸馏:把长视频和画布里散落的做法,提炼成 15 个节点的标准流程、每个节点的 prompt 骨架、命名规范与验收标准,再加上我自己实战项目(婚礼短片,以及后续多个测试片段)踩出来的几十条坑位清单——最终变成一套AI Agent 可以直接照着执行的生产规范。这样你可以:
- 直接使用:拿到 Skill 就能开工,不用先看一小时视频、不用自己总结;
- 回到源头查看:想深入理解原始思路,可以去看原视频与原画布(链接在下面),两者互补。
| 原始来源 | 链接 | 说明 |
|---|---|---|
| 原视频 · 专业流程讲解 | B站 BV1YURLBTEwi | 《目前最详细的AI影视剧创作专业流程讲解》:运用传统影视工业流程思维,1 小时完整讲解 |
| 原视频 · H3 工作流讲解 | B站 BV1w1u26hEQ7 | 《MiniMax H3 AI影视剧专业创作流程思路讲解》:多合一工作流、提示词 Skills、使用技巧 |
| 原画布 · 范例《赛博精神病诊疗》 | RunningHub canvas 2099660115945123841 | RHTV 原范例画布(需登录 RunningHub 查看) |
| 原 TV 项目入口 | RunningHub camp 2050163786811203586 | RHTV 项目页(需登录) |
说明:原始视频与画布版权归原作者所有,本页仅作来源标注与学习指引;本 Skill 中的蒸馏规范、扩展节点与踩坑清单为原创整理。
三条「铁律」,比任何提示词都重要
铁律一:画面里永远不要出现文字
模型生成的文字 99% 是乱码,而且会毁掉镜头。所有字幕、标题、祝福语一律后期叠加;生成阶段的 prompt 里必须显式禁止「字幕/文字/水印/Logo」。这条从第一节点贯彻到最后交付。
铁律二:参考底和最终风格要分层
角色三视图 / 定妆 / 服装 / 道具这些资产阶段全部用写实摄影棚风格(中性白 T、纯灰背景),最后的首帧和视频才套用项目风格(3D 仙侠 / 写实都市 / 胶片复古)。把最终风格提前绑死在资产上,后面所有服装场景都要重做。
铁律三:锁脸只用「脸部裁切特写」
身份参考禁止使用整张生活照或定妆图全图——脸占比太小,身份信号会被稀释。正确做法是从三视图和定妆图里裁出面部特写作为参考,画面里有几个人就给几张裁切,prompt 里逐张绑定「谁的脸以哪张为准」。
一条「强制门禁」:生成前先做白模预演
这套流程里有一个别家教程很少提的环节,也是成片质量的保险丝:凡是复杂段落,进首帧生成之前,默认先做一次 3D 白模预演(用 Blender 或网页白模工具搭出场景、摆好人物、排好镜头),产出一段"结构参考视频"。
它解决的是 AI 视频最贵的浪费:一条 10 秒镜头生成要花钱花时间,构图/遮挡/走位错了,重做就是双倍成本。白模预演把"结构问题"提前暴露在便宜的环节——预演视频还能直接作为正式生成时的结构参考(video1 槽位)。
下面任一条件成立时,这道门禁不得跳过:
- 画面里有两名以上角色;
- 镜头有推拉、摇移、跟随、升降或明显景别变化;
- 场景里有门、镜子、台阶、桌面这类影响遮挡的结构;
- 需要复现参考视频的动作节奏或空间连续性;
- 该段之前出现过人物漂移、道具消失、灰棚污染、跳景或接缝问题。
真实踩坑:AI 影视生产会被「整」的 N 种死法
下面这些坑全部来自真实生产(婚礼短片实测 + 流程验证),每一条都对应流程里的一条验收标准——这些才是这套 Skill 里最贵的部分:
| 你看到的现象 | 真实原因 | 流程里的防法 |
|---|---|---|
| 反复生成,人物就是不是本人 | 初始身份裁切拿错了——根源在第一步就错,后续 prompt 救不回来 | 先确认"哪张是谁";只用批准过的脸部裁切 |
| 修一个人,结果全家人脸都开始漂 | 参考图只覆盖目标人物,但模型连带改了别人 | 全员脸部裁切逐张绑定,保留眼镜、年龄感,逐一对照验收 |
| 脸看起来没问题,下游还一直漂 | 三视图那一步本身就漂了、脸在整图里太小 | 查资产链回到源头修,不换回随意生活照 |
| 越修越怪,错构图被"焊死" | 把坏图当构图参考又喂了回去——错误被迭代强化 | 只用批准过的锚点;坏图永不回喂 |
| 双人相框里出现两个新郎/拼接脸 | 竖框比例不适合横向双人照,模型自己裁剪重组 | 先检查镜框几何;真实照片优先后期贴入空框 |
| 古装片里烟花一切景回到现代 | 只写了"放烟花",没有绑定主片世界观 | 绑定尾帧、全员身份和场景,只喂本镜出镜角色 |
| 同样的 6 张参考,有时成功有时失败 | 其他参数(工作流/时长)其实不同 | 记录完整配方;不把一次成功写成无条件支持 |
| 高清整片只完成了"烟花测试片" | 覆盖范围没核对完整时间轴 | 逐片检查范围/顺序/帧数/总时长 |
| 片段尾部突然一切景变"灰色摄影棚" | 身份参考的风格污染了场景——照片被模型当成全场景参考 | prompt 连写三遍"照片只在镜框内 + NEVER grey studio";锚点锁场景 |
| 双竖窄框里放横版合照=裁剪灾难(被读成"两个男人") | 镜框比例与照片比例冲突,模型自行裁剪重组 | 双槽喂同一张照片;真实照片优先后期透视贴入空框 |
一部真实成片的数字账(全流程实测)
空谈流程不如上账本。这是一部真实交付的婚礼短片——从 11 个镜头到最终成片——的全部真实数字:
| 环节 | 实测数字 |
|---|---|
| 成片规模 | 11 镜 / 5 段 + 4 条 3 秒 AI 过渡;最终 76.208 秒、24fps、1829 帧、高清 2880×1664 |
| 单条视频生成(H3) | ¥0.064 / 条(10.1 秒,墙钟约 329 秒);5 条 10s 批量约 ¥0.32 |
| AI 过渡段 | 3 秒过渡 ¥0.02–0.04 / 条 |
| 整片高清(FlashVSR) | 切成 10 片逐片处理,全片约 ¥0.785 |
| 试错量 | 累计生成 106 条视频,其中 34 条被否归档(修复后重生成)——成品率约为 2/3 |
| 交付包 | 全片 348MB(含字幕版) |
生产现场:一次真实短片从 0 到交付经历了什么
再说一个真实场景——《天喜金卷》婚礼祝福短片(为家人做的 60 秒片子,5 段 / 11 镜,3D 国漫仙侠风)。这是流程第一次跑全链,过程全部留在工作记录里,照原样给你看:
| 阶段 | 现场发生了什么 |
|---|---|
| ① 资产与提示词 | 11 镜分镜转成 11 条结构化 H3 生成提示词(自动生成器产出 35.9KB 的 prompt JSON),每一条绑定锚点、出镜角色脸部裁切、对白音频 |
| ② 先做小规模验证 | 不直接批量——先跑两轮 PoC:1:1 画幅验证 三人脸锁 100% 守住;16:9 画幅验证分辨率与表情变化(弟弟张口、侄媳笑)→ 16:9 解锁,确认可用才进入批量 |
| ③ 遇到配额墙 | 云端视频配额是有限的(每 5 小时 3 条)——11 镜单镜跑会卡死。策略调整:按段落合并成 3 次生成(前 3 段 1 次、第 4 段 1 次、第 5 段 1 次),用配额换进度 |
| ④ 上游服务挂了 | 锁脸环节的首选服务商突然 502(云服务端故障,重试依然挂)→ 自动切换备用服务商,一次成功。这就是 fallback 链在实战里救命的样子 |
| ⑤ 一个动作的歧义 | "拱手作揖贺喜"被模型理解成了"拜佛"——动作描述的词序差异,产出完全不同的画面。这类问题只能靠验收环节抓住 |
| ⑥ 首段门禁 | 批量前先出第一段给你看——你拍板后,才批量生成剩余 4 段,避免 5 段一起翻车重做 |
生图阶段:模型怎么选
资产和首帧全部走统一的生图路由,按场景复杂度切换档位,不需要自己反复试错:
| 场景特征 | 用什么 | 为什么 |
|---|---|---|
| 单人物大头 / 三视图 / 单人单道具 | 默认主力模型 | 性价比最高、锁脸最稳 |
| 多人同框(全家福等) | 升级档模型 | 默认档容易「崩脸」,多人必须升级 |
| 多光源 / 复杂光影(烛光夜戏) | 光影特化档 | 默认档容易糊 |
| 中文纹饰(印章、牌匾细节) | 光影特化档 | 默认档容易把纹饰生成成乱码字 |
| 最终首帧 / 四宫格交付 | 4K 档 | 最终画面分辨率要求 |
价格参考:常规 1–2K 成图每张约 ¥0.03–¥0.3(按档位不同);交付级 4K 约 ¥0.4/张级。一部 16 镜短片的前期资产+首帧总成本通常在一杯咖啡的预算内。
视频阶段:为什么是「按段生成」而不是整片一次出
当前所有主流视频模型都有一个共性缺陷:时长越长、镜头越多,崩得越厉害。金鱼流程的做法是——把视频按故事情节切成 8–12 秒的「段」,每段内部包含 2–4 个镜头,一段一次生成:
- 输入 = 该段分镜脚本 + 已批准的首帧锚点 + 全员脸裁切 + 该段对白参考音频 + 结构化 prompt;
- 对白用专用标记写进 prompt,模型直接原生生成口型;
- 段与段之间用「同场景过渡生成」衔接(叠化/声音桥/AI 过渡段),禁止硬切产生跳变;
- 前一段验收通过后才生成下一段,避免批量出废片。
成本参考:海外云端生成一条 10 秒段约 ¥0.06(按实际任务计价);一部 1 分钟短片的视频生成总成本约 ¥0.3–0.5。真正的时间成本在「挑参」和「复检」,而不在生成费用。
后期阶段:决定成片「专业感」的三步
- 剪辑 + 修音:以原生对白构建时间轴;只修局部错音,不用整片 TTS 覆盖;先检查每段原生环境音再决定要不要补音乐。
- 整片高清(FlashVSR):按帧覆盖整片放大,分片处理、按序拼接、恢复批准音轨,逐项检查尺寸、帧数和接缝。
- 字幕 + 交付:从最终音轨识别字幕并逐句校对,从无字幕高清母版压制;交付包含完整文件名、时长、尺寸、大小与校验值。
常见问题
没有剪辑基础能做吗?能。流程里每个节点的产出物都是标准化的,剪辑与字幕有固定规范,不需要专业剪辑背景;难点主要在「按流程执行、不跳步」。
要做多长的片子?流程本身不限时长,实践中 1–5 分钟的短片最合适(1 分钟约 6–8 个视频段)。
要花多少钱?生图按张(¥0.03–¥0.4/张)、视频按段(约 ¥0.06/条 10 秒)、高清按整片时长计费。一部 1 分钟短片完整制作通常在人民币个位数到几十元的云成本区间,具体取决于重跑次数。
可以商用吗?可以,但需遵守所用模型平台的服务条款;涉及真人肖像的(如婚礼项目)需取得本人授权。
关于本文与说明
文中成本数字为当前时点的实测参考,不作为报价承诺。
主页:aizhuozhi.com。